모두가 같은 AI를 쓴다면, 차이는 어디서 생길까: 뇌과학으로 본 엔지니어의 고흡수력
코드 생성 비용이 0에 수렴하는 AI 시대, 엔지니어링의 핵심 병목은 '작성'에서 '흡수와 검증'으로 이동했습니다. 인지과학의 작동 기억, 스키마 청킹, 멘탈 시뮬레이션을 통해 고흡수력 엔지니어가 시스템 무결성을 지켜내는 원리를 살펴봅니다.
Engineering, AI, Cognitive Science, Architecture, Software Engineering, Learning
소프트웨어 개발의 역사에서 생산성을 가로막는 병목(Bottleneck)은 언제나 '작성(Writing and Coding)'에 있었습니다. 요구사항을 머릿속에서 정리하고, 적절한 문법과 라이브러리를 탐색하며, 한 줄 한 줄 타이핑하여 코드로 실체화하는 데 대부분의 시간과 에너지가 소모되었습니다.
그러나 LLM과 AI 코딩 어시스턴트의 등장은 이 구조를 근본적으로 뒤흔들었습니다. 이제 복잡한 비즈니스 로직, 데이터 변환 파이프라인, 단위 테스트 스위트를 수초 만에 생성하는 데 드는 한계 비용은 사실상 0에 수렴합니다 [1] [2].
이 지점에서 중대한 패러다임 전환이 발생합니다. 코드의 생성 비용이 극단적으로 낮아지면서, 개발 현장의 병목은 "누가 더 빠르고 유려하게 코드를 작성하는가" 에서 "쏟아져 나오는 코드와 시스템 설계를 얼마나 빠르고 정확하게 소화하고 검증하는가" 로 이동했습니다 [3] [4] [5].
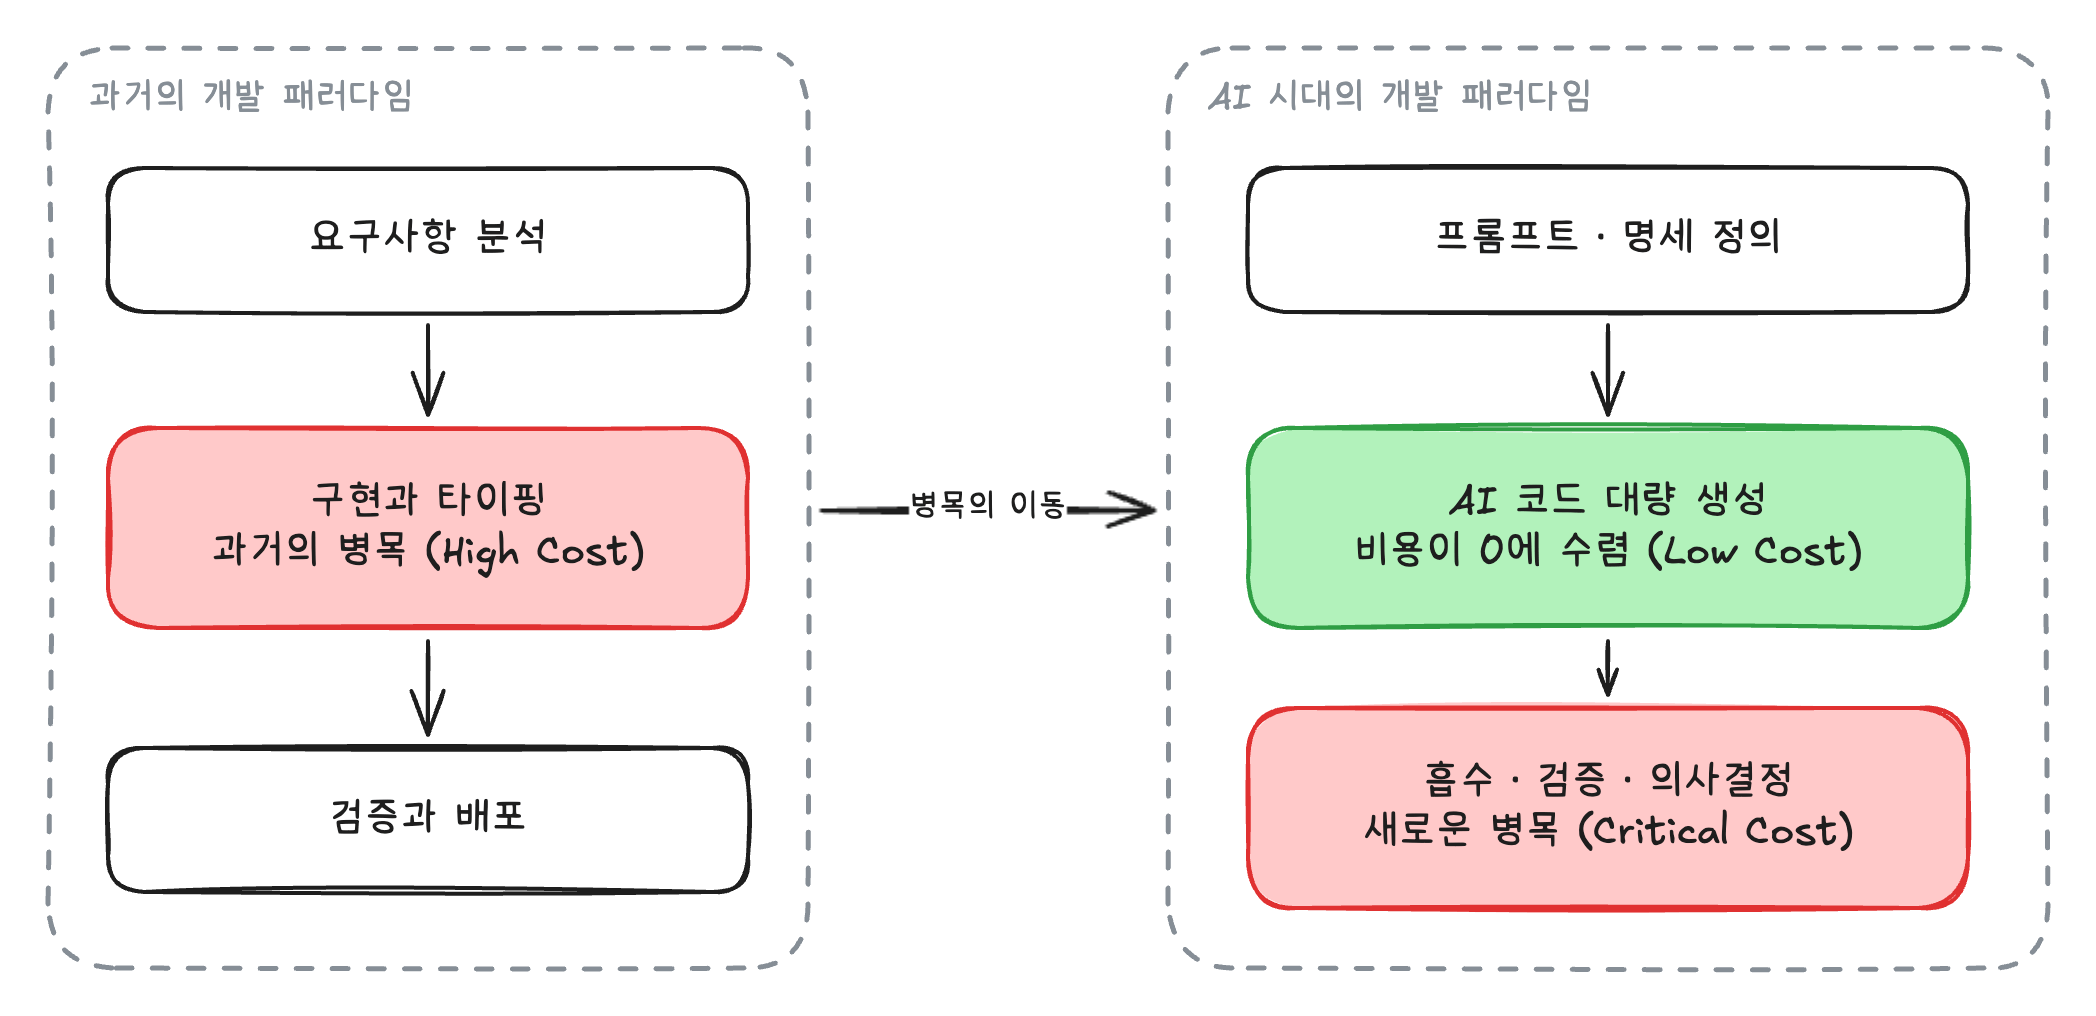
경제학자 허버트 사이먼(Herbert A. Simon)은 일찍이 주의 경제학(Attention Economics)을 제창하며 다음과 같은 명제를 남겼습니다.
"정보의 풍요는 주의력의 빈곤을 낳고, 그 정보가 소비하는 대상의 결핍을 초래한다. 정보가 소비하는 것은 명백하게도 그것을 받아들이는 자의 주의력이다."
— Herbert A. Simon, 1971
AI 시대에 엔지니어의 주의력과 뇌 용량은 극도로 희소한 자원이 되었습니다. 쏟아지는 생성 정보 속에서 본질을 꿰뚫고 시스템의 무결성을 지켜내는 힘, 즉 '고흡수력(High Absorptive Capacity)' 이 엔지니어의 핵심 경쟁력으로 부상한 이유입니다.
그렇다면 인간의 뇌는 AI가 생성한 방대한 정보를 어떻게 받아들이며, 왜 어떤 엔지니어는 수백 줄의 코드를 순식간에 흡수하고 어떤 엔지니어는 인지적 마비에 빠질까요? 인지과학과 뇌과학의 렌즈를 통해 그 메커니즘을 살펴봅니다.
뇌과학으로 해부한 코드 독해: 작동 기억과 인지 과부하
인간의 뇌가 새로운 코드를 읽고 이해하려 할 때 가장 먼저 부딪히는 물리적 한계는 작동 기억(Working Memory) 의 용량입니다.
인지심리학자 조지 밀러(George Miller)의 '매직 넘버 7±2', 그리고 넬슨 코완(Nelson Cowan)의 후속 연구에 따르면, 인간의 작동 기억이 동시에 유지하고 조작할 수 있는 독립된 정보 단위(Chunk)는 고작 4개 내외에 불과합니다.
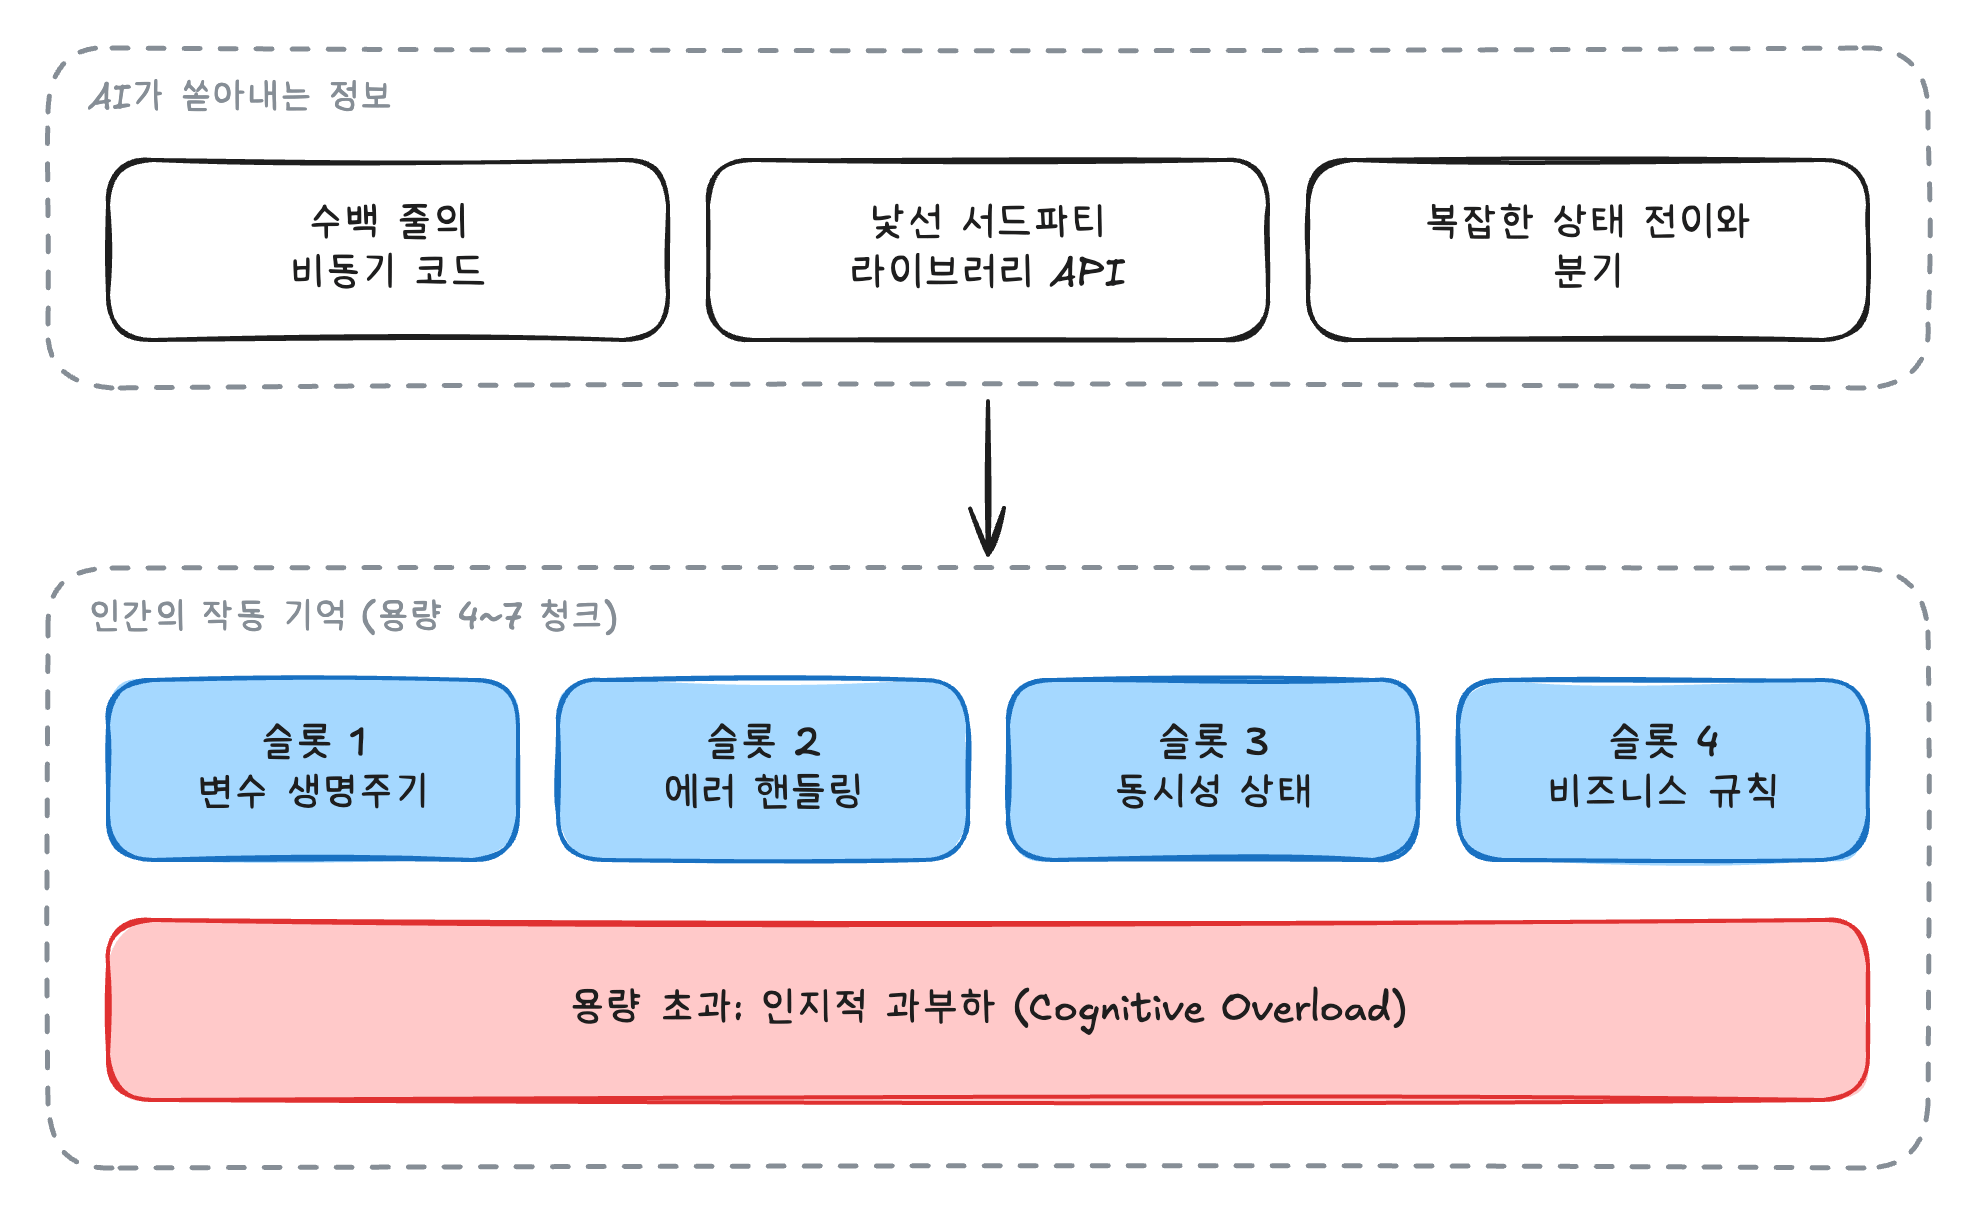
존 스웰러(John Sweller)의 인지 부하 이론(Cognitive Load Theory) 에 따르면, 인지 부하는 크게 세 가지로 분류됩니다:
- 본질적 인지 부하(Intrinsic Load): 해결하려는 비즈니스 도메인 문제 자체가 지닌 본래의 복잡성.
- 외재적 인지 부하(Extraneous Load): 비효율적인 코드 서술 방식, 불필요한 보일러플레이트, 맥락 없는 주석 등 정보 전달 방식 때문에 발생하는 불필요한 부하.
- 학습 관련 인지 부하(Germane Load): 뇌가 장기 기억에 새로운 스키마(지식 구조)를 구축하는 데 쓰이는 생산적인 부하.
AI 코딩 어시스턴트는 종종 수백 줄의 코드를 일시에 화면에 출력합니다. 이때 코드의 문맥과 세부 구현이 작동 기억의 한계(4~7개)를 순식간에 초과하면, 뇌는 인지적 과부하(Cognitive Overload) 상태에 진입합니다.
작동 기억이 포화되면 뇌는 더 이상 시스템의 데이터 흐름을 추론하거나 논리적 결함을 검증할 수 없습니다. 그 결과, 코드를 깊이 있게 이해하는 것을 포기하고 단순히 눈으로 글자를 훑는 '표면적 스캐닝'에 머물게 됩니다.
체스 그랜드마스터와 시니어 엔지니어: 스키마와 청킹의 마법
그렇다면 숙련된 시니어 엔지니어는 어떻게 AI가 생성한 방대한 아키텍처와 수백 줄의 코드를 불과 10~20초 만에 파악하고 결함을 찾아낼 수 있을까요? 시니어의 뇌가 주니어보다 훨씬 큰 작동 기억 용량을 타고났기 때문일까요?
인지과학의 답변은 단호하게 "아니다" 입니다. 체스 연구의 고전으로 꼽히는 네덜란드 심리학자 아드리안 더흐로트(Adriaan de Groot)의 실험이 이를 명쾌하게 증명합니다.
더흐로트의 체스 말 기억 실험 (De Groot's Experiment)
체스 그랜드마스터와 초심자에게 실제 경기 중의 체스판을 5초 동안 보여준 뒤, 말의 배치를 그대로 재현하게 했습니다. 그랜드마스터는 거의 100%에 가깝게 말의 위치를 복원한 반면, 초심자는 극히 일부밖에 기억하지 못했습니다.그러나 체스판 위의 말들을 실제 전술과 무관하게 '완전히 무작위' 로 배치하자 놀라운 결과가 나타났습니다. 그랜드마스터의 복원율이 초심자 수준으로 급락한 것입니다.
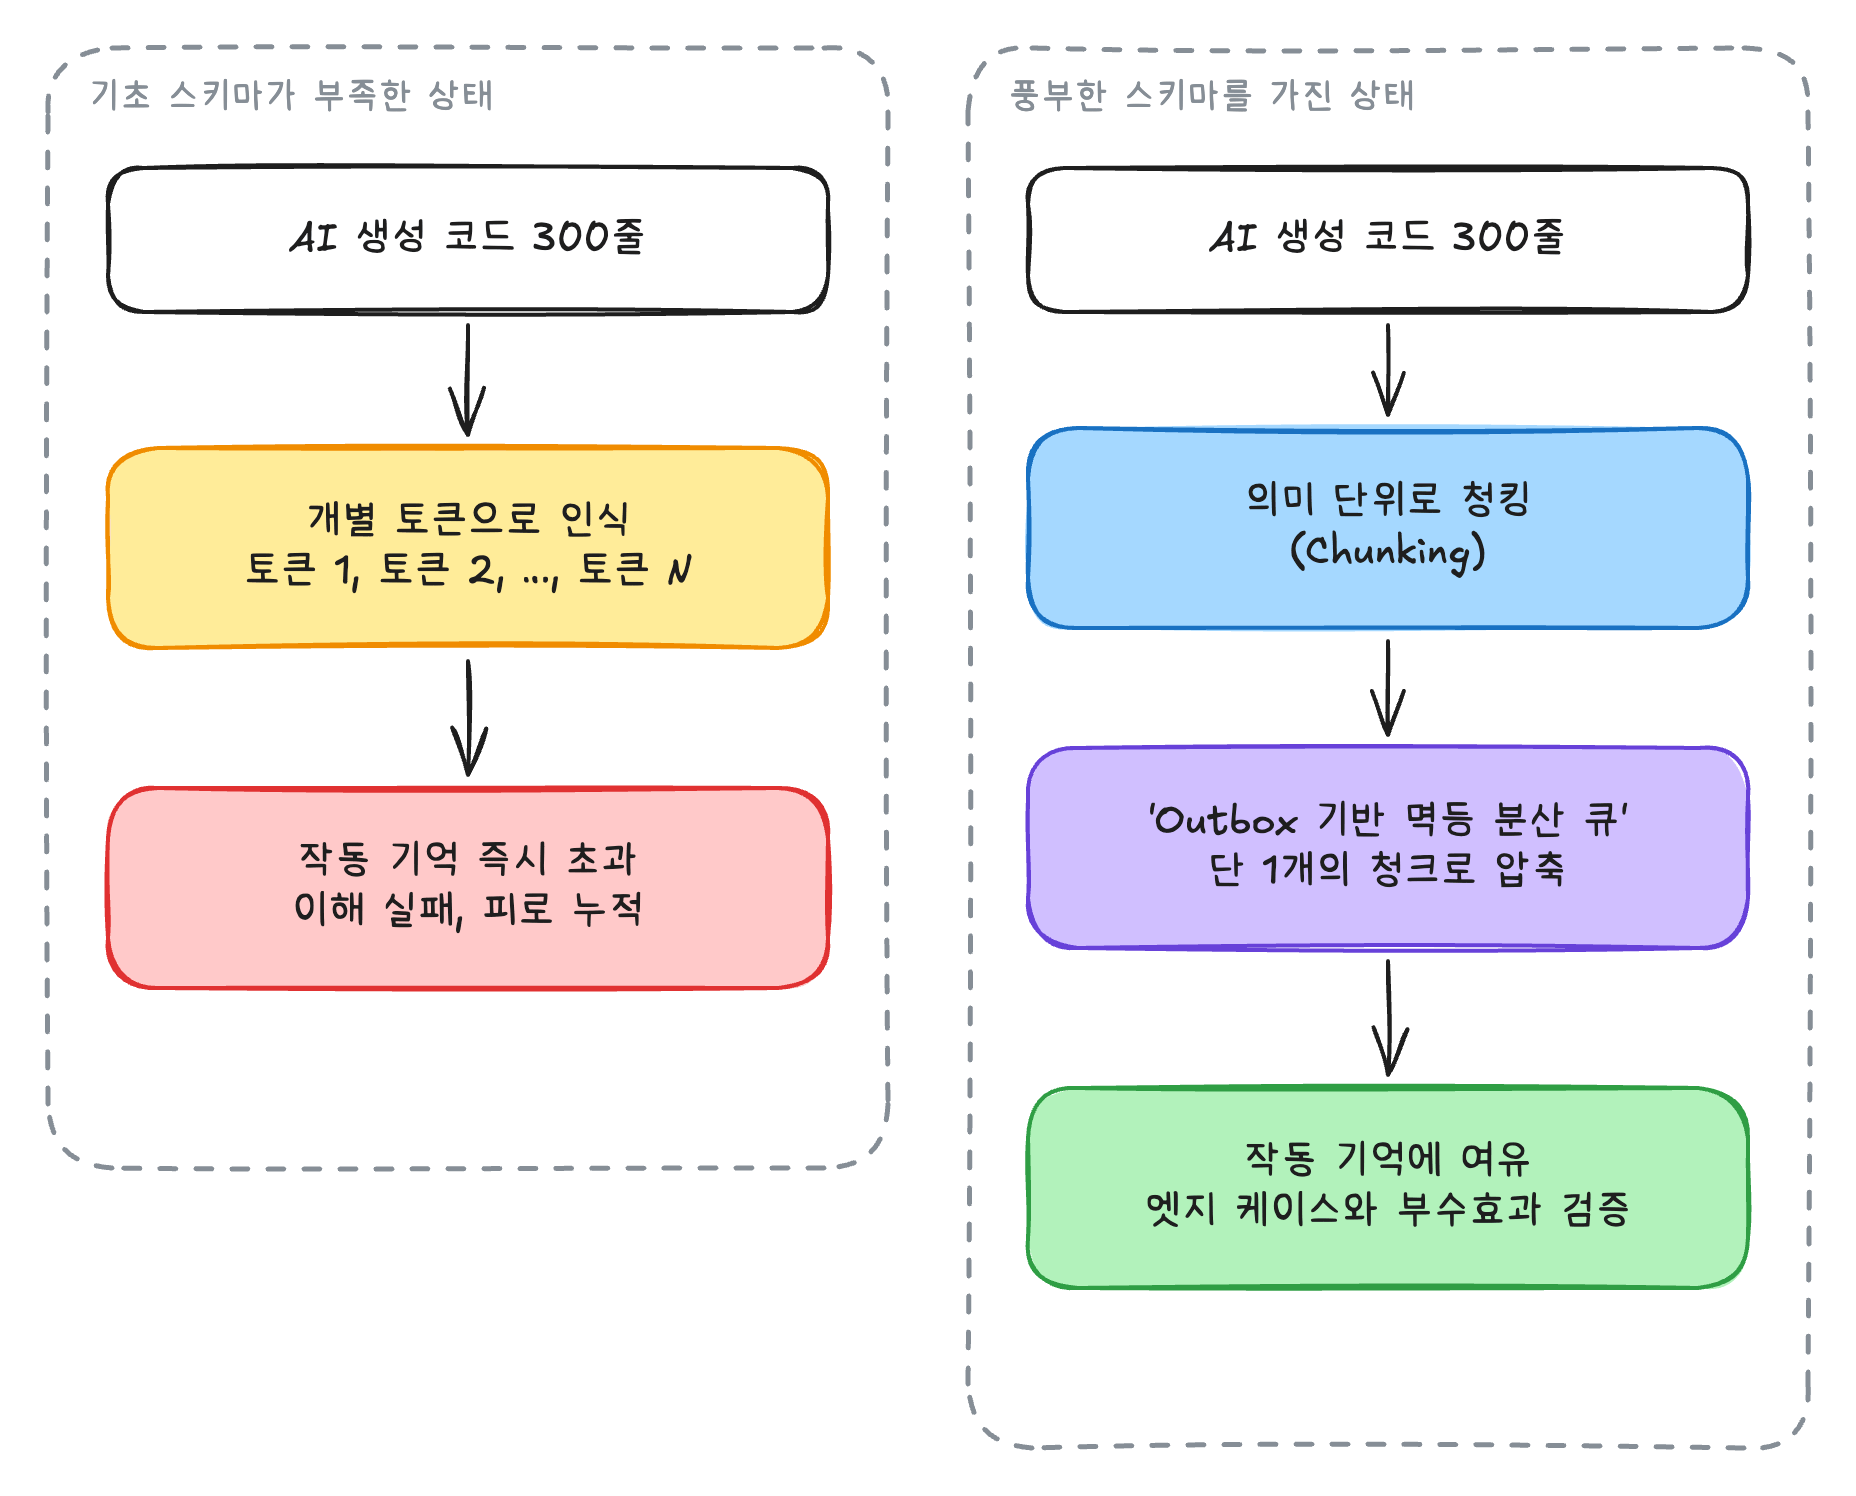
그랜드마스터의 경쟁력은 뛰어난 사진 기억력이 아니라, 장기 기억(Long-Term Memory)에 축적된 수만 개의 체스 전술 스키마(Schema) 에 있었습니다. 그들은 말을 낱개로 기억한 것이 아니라, "중앙을 압박하는 시칠리안 디펜스 변형"이라는 하나의 의미 있는 묶음(Chunk)으로 기억했습니다.
소프트웨어 엔지니어링에서도 정확히 동일한 인지 메커니즘이 작동합니다.
- 기초 스키마가 빈약한 엔지니어:
async,await,try,catch, 맵핑 함수, ORM 호출 등 코드의 모든 줄을 개별 토큰으로 읽습니다. 각 토큰이 작동 기억 슬롯을 하나씩 차지하므로, 열 줄만 읽어도 뇌에 과부하가 걸립니다. - 고흡수력 엔지니어: 장기 기억에 운영체제, 분산 시스템, 디자인 패턴에 관한 단단한 멘탈 모델이 구축되어 있습니다. 300줄의 코드를 읽는 즉시 "Transactional Outbox 패턴 기반의 비동기 메시지 발행기" 라는 단 1개의 고수준 청크(High-level Chunk) 로 압축하여 흡수합니다.
경영학자 웨슬리 코헨(Wesley Cohen)과 대니얼 레빈탈(Daniel Levinthal)이 1990년 제시한 흡수 역량(Absorptive Capacity) 이론은 이 원리를 조직과 개인 차원에서 명확히 요약합니다:
"새로운 외부 지식의 가치를 식별하고, 이를 동화(assimilate)하며, 상업적·실무적 목적에 적용하는 역량은 전적으로 사전에 축적된 관련 선행 지식(Prior related knowledge) 에 비례한다."
결국 AI 코드를 빛의 속도로 흡수하는 힘은 마법 같은 속독 기술에서 나오는 것이 아닙니다. 장기 기억에 저장된 선행 지식의 두께와 정밀한 스키마 가 뇌 내부의 압축 알고리즘으로 작동하기 때문입니다.
가장 위험한 인지적 함정: 유창성의 착시(Illusion of Fluency)
AI 코딩 환경에서 엔지니어가 빠지기 가장 쉬운 뇌과학적 함정은 '유창성의 착시(Illusion of Fluency)' 입니다.
인지심리학에 따르면, 인간의 뇌는 외부에서 들어오는 정보가 매끄럽고 일관되게 처리될 때 인지적 편안함(Cognitive Ease)을 느끼며, 이를 "내가 이 개념을 완전히 이해했다" 는 확신으로 오인하는 경향이 있습니다.
AI가 작성한 코드는 대체로 다음과 같은 특징을 갖습니다:
- 문법적으로 결함이 없으며 들여쓰기와 스타일 가이드가 완벽합니다.
- 변수명과 함수명이 그럴듯하며 직관적입니다.
- 각 단계마다 친절하고 유려한 주석이 달려 있습니다.
// 얼핏 완벽해 보이지만 동시성 결함(Race Condition)을 내포한 예시
export async function updateWalletBalance(userId: string, amount: number) {
  // 1. 사용자 지갑 조회
  const wallet = await db.wallets.findOne({ userId });
  if (!wallet) throw new Error("지갑을 찾을 수 없습니다.");

  // 2. 잔액 검증
  const newBalance = wallet.balance + amount;
  if (newBalance < 0) throw new Error("잔액이 부족합니다.");

  // 3. 지갑 잔액 갱신
  await db.wallets.updateOne({ userId }, { balance: newBalance });
  return newBalance;
}
위 코드를 읽는 초심자의 뇌는 주석과 변수명이 주는 인지적 유창성에 취해 "이해하기 쉽고 완벽한 코드" 라고 판단하며 PR을 승인(LGTM)합니다.
그러나 이 코드는 분산 환경에서 두 개의 요청이 동시에 인입될 때 데이터 무결성을 파괴하는 치명적인 경쟁 상태(Race Condition / Lost Update) 문제를 안고 있습니다.
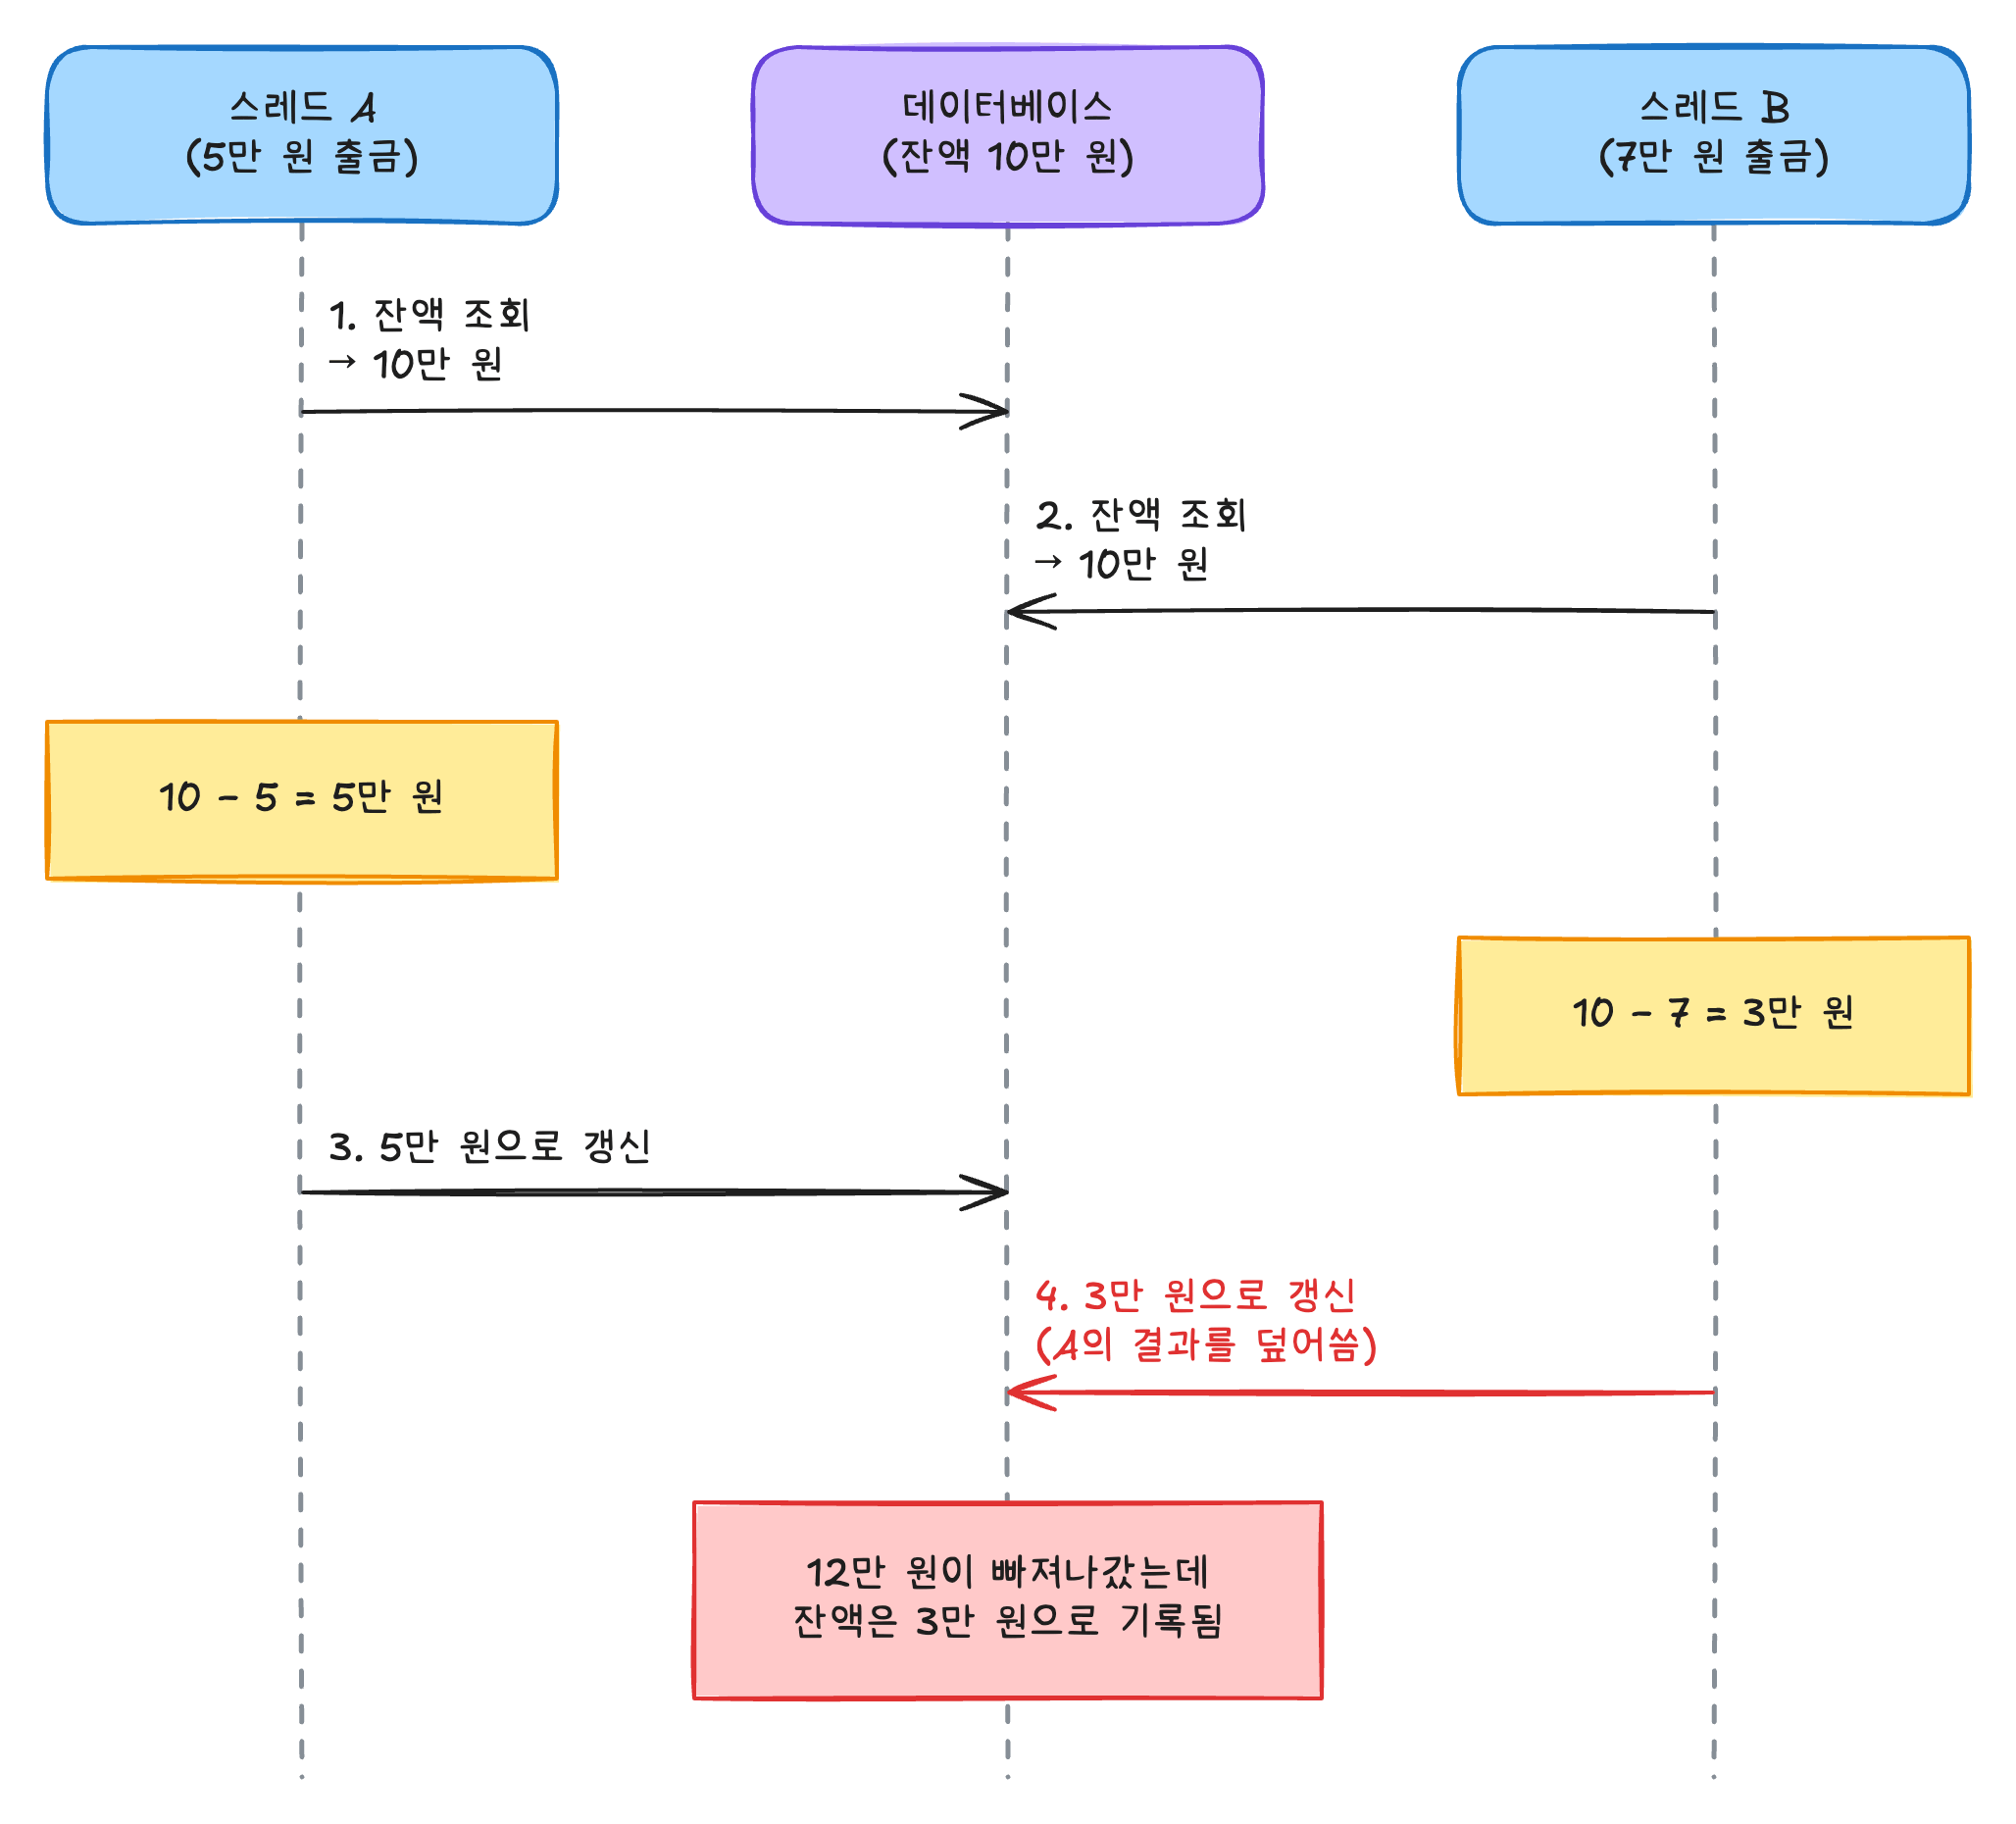
이것이 바로 생성형 기술 부채(Generative Tech Debt) 의 본질입니다.
코드는 깔끔하게 작동하는 것처럼 보이지만, 그것을 승인한 엔지니어의 뇌 속에는 시스템의 물리적 런타임 한계(트랜잭션 격리 수준, 비관적/낙관적 락, 멱등성 보장)에 대한 멘탈 모델이 부재합니다. 직접 고민하고 실패하며 시냅스를 형성하는 과정 없이 외부에서 주입된 지식은 뇌의 장기 기억으로 전이되지 않기 때문입니다.
결국 시스템에 장애가 발생하는 순간, 코드를 생성했던 AI도, 그것을 무비판적으로 승인했던 엔지니어도 원인을 즉각 추적하지 못하는 '시스템 통제권 상실(Loss of Controllability)' 상태에 직면하게 됩니다.
고흡수력 엔지니어의 핵심 기제: 머릿속 런타임 멘탈 시뮬레이션
고흡수력을 지닌 엔지니어와 그렇지 못한 엔지니어를 가르는 결정적 차이는 '멘탈 시뮬레이션(Mental Execution / Internal Simulation)' 능력에 있습니다.
컴퓨터 과학자이자 인지과학자들은 뛰어난 프로그래머의 뇌가 코드를 읽을 때, 단순한 텍스트 파싱을 넘어 머릿속에 가상의 런타임 엔진(Mental VM) 을 구동한다는 사실을 밝혀냈습니다 [6] [7] [8].
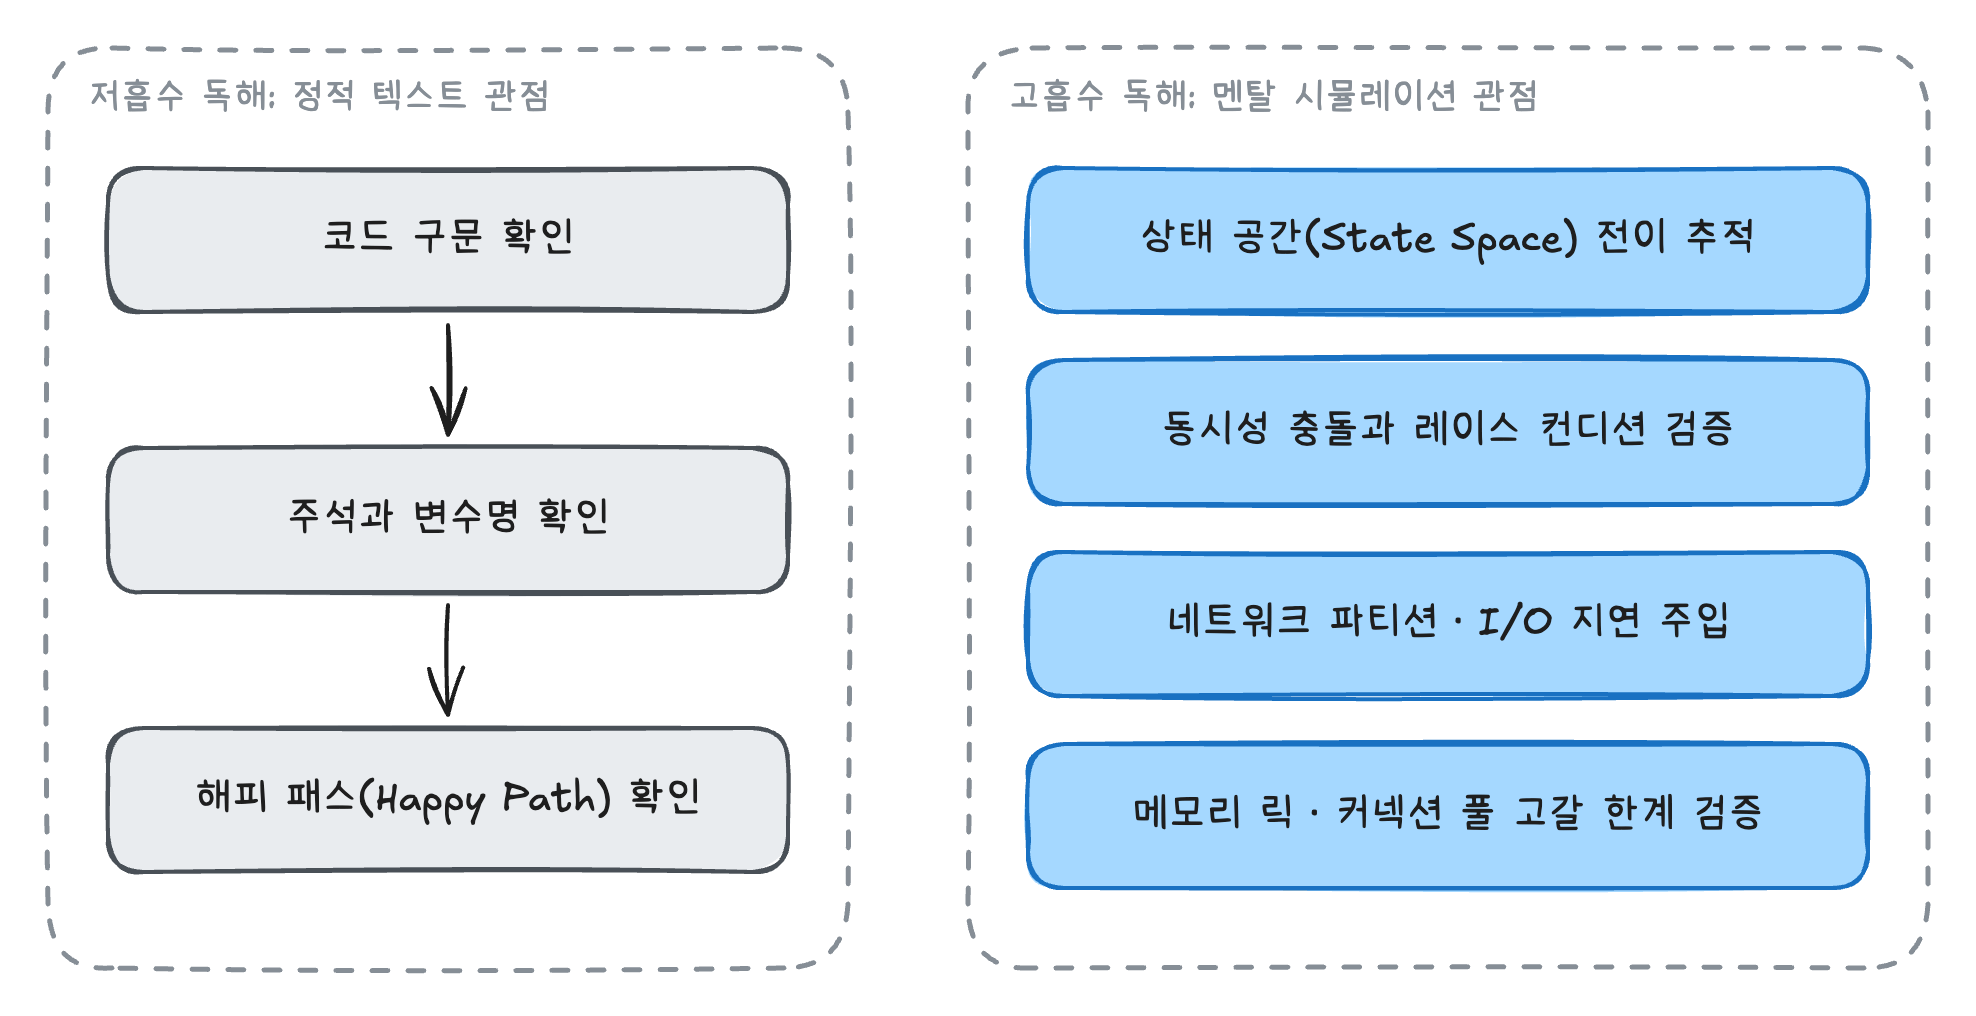
AI는 기본적으로 프롬프트의 맥락 안에서 가장 그럴듯한 해피 패스(Happy Path) 를 생성하는 데 최적화되어 있습니다. 반면 고흡수력 엔지니어는 AI가 제시한 코드를 머릿속 가상 머신에 올리고 다음과 같은 파괴적 시뮬레이션 을 즉각 실행합니다:
- "이 비동기 루프에서 외부 API가 5초 동안 응답하지 않는다면 Node.js 이벤트 루프와 메모리 사용량은 어떻게 변하는가?"
- "데이터베이스 트랜잭션이 롤백될 때 발행된 이벤트 메시지는 어떻게 정합성을 회복하는가?"
- "이 컴포넌트가 부모의 상태 변경으로 리렌더링될 때 내부 클로저가 캡처하는 참조값은 안전한가?"
고흡수력 엔지니어에게 코드 독해는 텍스트를 읽는 수동적 감상이 아닙니다. AI가 제안한 가설을 자신의 멘탈 모델 내부에서 극한의 부하를 주어 회전시켜 보는 능동적 시뮬레이션 과정 입니다.
고흡수력 뇌를 구축하는 3가지 실천적 엔지니어링 프로토콜
그렇다면 엔지니어는 쏟아지는 AI 생성 정보 속에서 어떻게 뇌의 흡수 역량을 의도적으로 단련할 수 있을까요? 인지과학적 학습 원리에 기반한 세 가지 실천 지침을 제안합니다.
1. 가설 우선 프로토콜 (Priming Before Prompting)
AI에게 프롬프트를 입력하기 전, 단 30초라도 자신만의 개념적 설계나 의사코드(Pseudocode)를 먼저 작성 하십시오.
- 뇌과학적 이유: 인지심리학에서 프라이밍(Priming, 점화 효과) 은 장기 기억의 관련 스키마를 미리 활성화하여 작동 기억의 정보 처리 효율을 극대화하는 기제입니다.
- 실천 방법: 백지상태에서 AI의 답변을 받으면 뇌는 수동적인 '유창성의 착시'에 빠집니다. 반면 내가 먼저 거친 아키텍처 가설을 세워두면, AI의 코드가 쏟아져 나오는 순간 뇌는 "내 가설과 AI의 출력 간의 오차(Prediction Error)" 에만 주의를 집중합니다. 이를 통해 작동 기억 부하를 획기적으로 낮추고 핵심 결함을 즉각 포착할 수 있습니다.
2. 소크라테스식 능동적 심문 (Active Interrogation & Inversion)
AI가 작성한 코드를 읽고 끝내지 말고, 시스템의 취약점을 파고드는 반례 질문(Edge Case Interrogation) 을 AI에게 역으로 던지십시오.
- 뇌과학적 이유: 지식은 외부 정보를 수동적으로 수용할 때가 아니라, 뇌가 기억을 능동적으로 인출하고 반박할 때 시냅스 구조로 공고화됩니다(Active Retrieval).
- 실천 방법:
- "이 구조에서 서비스 워커 캐시와 CDN 캐시가 불일치할 때 발생할 수 있는 장애 시나리오는 무엇인가?"
- "이 알고리즘의 시간 복잡도가 이지만, 메모리 제약 환경에서 GC 압박을 유발할 여지가 있는가?"
- AI를 단순히 정답을 출력하는 기계가 아니라, 내 멘탈 모델의 견고함을 시험하는 대화형 테스트베드로 활용하십시오.
3. 제1원리(First Principles)와 CS 기초 체력으로의 회귀
최신 프레임워크의 문법적 트렌드보다 컴퓨터 과학의 불변하는 기초 원리(CS Fundamentals) 에 의도적으로 시간을 투자하십시오.
- 뇌과학적 이유: 라이브러리의 API 시그니처는 수시로 바뀌지만, 운영체제의 가상 메모리 관리, 네트워크의 패킷 전송 규약, 데이터베이스의 동시성 제어 모델은 수십 년간 동일한 물리적 법칙 위에 서 있습니다.
- 실천 방법: 이러한 기초 원리야말로 어떤 새로운 프레임워크나 AI 생성 코드가 주어지더라도 단숨에 맥락을 꿰뚫어 볼 수 있게 해주는 최상위 인지 스키마(Meta-Schema) 입니다. 기본기가 단단할수록 AI가 뱉어내는 낯선 코드의 흡수 속도는 기하급수적으로 빨라집니다.
마치며: AI 시대의 10x 엔지니어
과거의 10x 엔지니어가 남들보다 10배 많은 코드를 빠르게 타이핑해 내는 사람이었다면, AI 시대의 10x 엔지니어는 남들보다 10배 높은 흡수력으로 시스템의 무결성을 검증해 내는 사람 입니다 [9] [10].
AI는 무한한 양의 코드를 생성할 수 있지만, 그 코드가 실제 물리적 서버와 런타임 환경에서 일으킬 부수효과를 책임질 수는 없습니다. 책임과 통제는 오직 시스템을 완벽히 흡수하고 이해한 인간 엔지니어의 몫입니다.
도구의 화려함에 매몰되어 생성에만 몰두할 것인가, 아니면 뇌의 인지적 스키마를 단련하여 거대한 흐름을 통제하는 흡수자가 될 것인가. AI 시대를 마주한 모든 소프트웨어 엔지니어가 스스로에게 던져야 할 질문입니다.
참고 문헌 및 연구 자료 (References)
Footnotes
-
Becker, B. A., et al. (2023). "Programming Is Hard - Or at Least It Used to Be: Educational Opportunities and Challenges of AI Code Generation", ACM SIGCSE / CACM. (코드 구문 작성이 더 이상 주된 장벽이 아니게 된 패러다임 변화 분석)
-
McKinsey & Company (2023). "Unleashing developer productivity with generative AI", McKinsey Digital Report. (생성형 AI 도입에 따른 작업 시간 단축 및 엔지니어링 가치 사슬의 상위 레벨 이동 분석)
-
Google Cloud DORA Team (2024–2025). "Accelerate State of DevOps Report", DevOps Research and Assessment (DORA). (AI 도입으로 개별 Throughput은 증가했으나 Code Review Bottleneck 및 Verification Tax가 발생함을 실증 분석)
-
Harding, B., & GitClear Research Team (2024). "Coding on Copilot: 2023–2024 Data Shows Downward Pressure on Code Quality", GitClear Empirical Study (153M LOC analyzed). (코드 턴오버율 2배 급증, 중복 코드 증가 및 유지보수·검증 비용 폭증 실증 데이터)
-
Cihan, N., et al. / ACM/IEEE ICSE (2024–2025). "Automated Code Review in Practice: Lessons from Industrial Deployments of LLMs", arXiv:2412.18531 / IEEE/ACM ICSE. (AI 생성 코드의 결함으로 인한 리뷰어 인지 부하 증가 및 Reviewer Capacity Gap 규명)
-
Siegmund, J., et al. (2014). "Understanding Understanding Source Code with Functional Magnetic Resonance Imaging", ACM/IEEE 36th International Conference on Software Engineering (ICSE). (fMRI 뇌 영상 측정을 통해 프로그래머가 코드 독해 시 작동 기억과 인지 제어 영역을 동원하여 '정신적 실행(Mental Execution)'을 수행함을 규명)
-
Ivanova, A. A., et al. (2020). "Comprehension of computer code relies primarily on domain-general executive brain regions", eLife, 9:e58906. (MIT 연구: 코드 이해가 언어 네트워크를 넘어 복잡한 논리 및 상태 추적을 담당하는 다중 요구 시스템(Multiple Demand System)을 전면 동원함을 입증)
-
Sorva, J. (2013). "Notional Machines and Introductory Programming Education", ACM Transactions on Computing Education (TOCE), 13(2), pp. 1–31. (프로그래머가 머릿속에 구축하는 컴퓨터 런타임 추상 모델인 '개념적 기계(Notional Machine)' 이론 체계화)
-
Gartner (2024). "Top Strategic Technology Trends: AI-Augmented Software Engineering", Gartner Research. (코드 생성 위주 최적화의 한계와 검증 및 품질 엔지니어링으로의 중심축 이동 제시)
-
Ozkaya, I. (2023). "Application of Large Language Models to Software Engineering Tasks: Opportunities, Risks, and Implications", IEEE Software, 40(3), pp. 4–8. (코드 생성 단가 하락이 시스템 복잡도를 팽창시키며, 아키텍처 설계와 시스템 검증이 핵심 역량이 됨을 설명)