평균의 함정과 Data의 입체적 지형도: 중심화, 퍼짐, 분포 형태를 관통하는 기술 통계학
왜 API 평균 응답 시간이 200ms인데 사용자는 서비스가 멈췄다고 느낄까요? 단 하나의 숫자에 매몰되지 않고 Data의 진짜 모습을 복원하는 기술 통계량의 3대 기둥(중심화, 산포, 형태)을 Interactive Simulation과 함께 살펴봅니다.
Statistics, DataAnalysis, Observability, Engineering, Interactive
Software System을 운영하거나 대규모 Data를 분석할 때, Engineer들이 가장 먼저 확인하는 지표는 단연 'Mean(평균)'입니다. Monitoring Dashboard에는 늘 Avg Latency: 215ms나 Average CPU Usage: 42% 같은 단일 요약 숫자가 거대한 Headline으로 자리 잡습니다.
그러나 Production 환경의 장애는 대개 이 평온한 평균값 뒤편에서 은밀하게 시작됩니다.
"Dashboard의 평균 응답 속도는 200ms로 완벽한 녹색 신호를 띄고 있었지만, 실제 상위 1%의 결제 요청은 15초 이상 지연되다 Timeout을 뿜어내고 있었습니다."
단 하나의 숫자는 수만 개의 Data가 공간 속에 어떻게 배치되어 있는지에 관한 거의 모든 Context를 소거합니다. 통계학에서 Data의 본질을 파악하기 위해 기술 통계량(Descriptive Statistics)을 중심화(Central Tendency), 흩어진 정도(Dispersion), 그리고 분포의 형태(Shape) 라는 3대 축으로 나누어 분석하는 이유가 바로 여기에 있습니다.
이 글에서는 복잡한 통계 공식을 한 번에 늘어놓지 않고, 각 축마다 해당 개념만을 직관적으로 조작할 수 있는 3개의 독립된 Interactive Lab 을 통해 세 가지 축의 역학 관계를 차례로 체감해 봅니다.
첫 번째 축: Data의 무게중심을 찾는 '중심화(Central Tendency)'
중심화는 방대한 Data 집합을 대표할 수 있는 "하나의 중심 위치"를 찾는 작업입니다. 고전 통계학과 실무에서는 주로 세 가지 지표를 활용합니다.
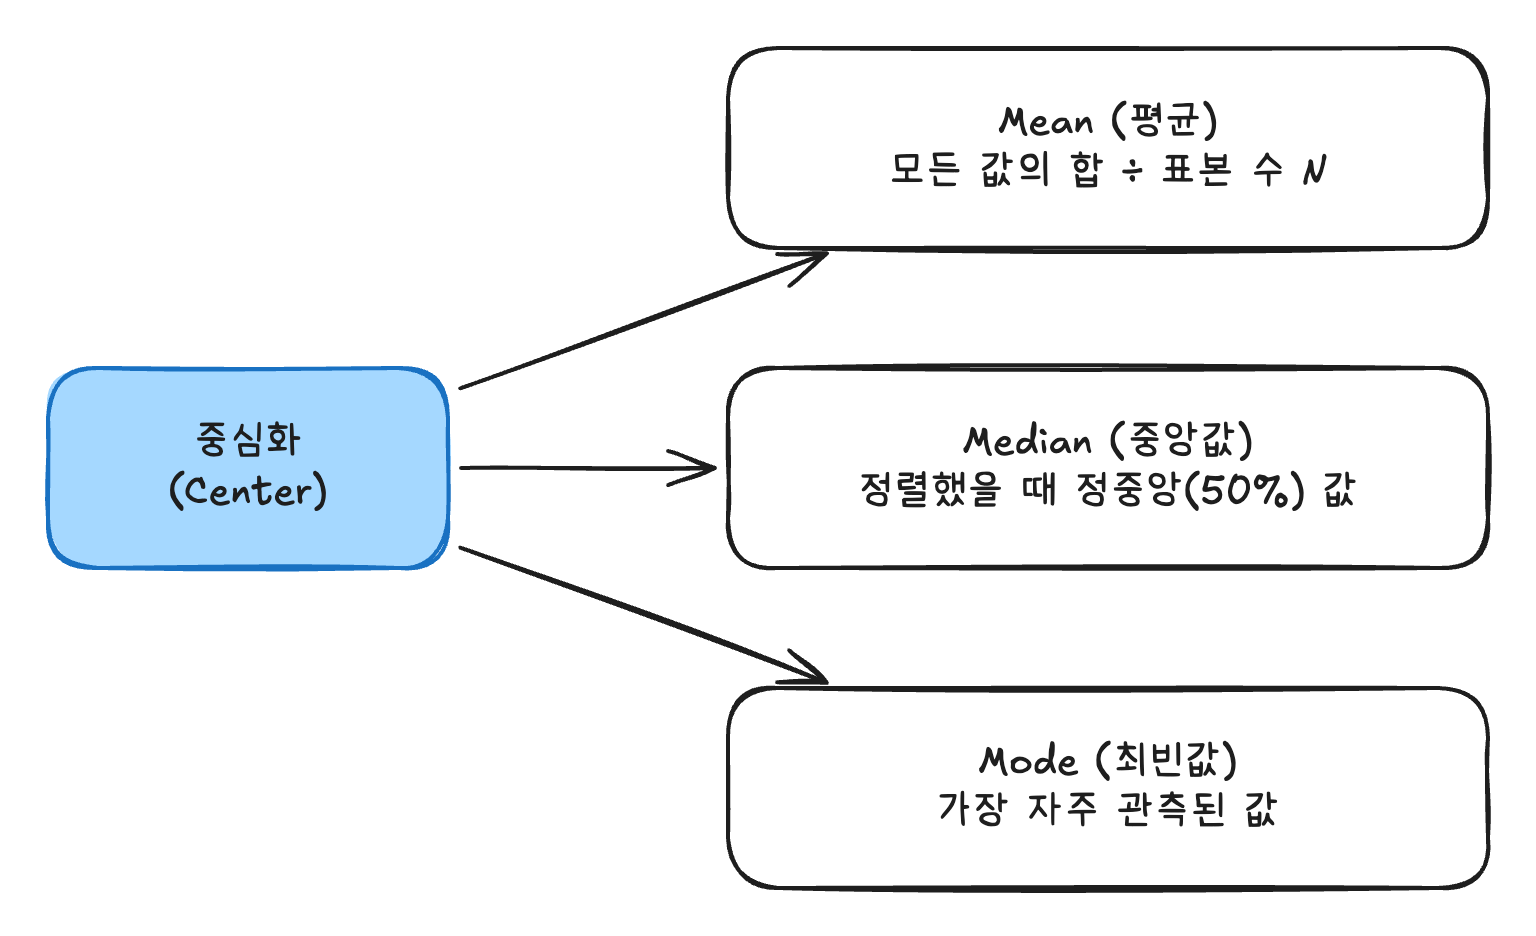
1. 산술 평균(Arithmetic Mean)의 치명적 취약성
산술 평균은 모든 Data의 크기를 동등하게 합산하여 나눕니다. Data가 종 모양의 완벽한 대칭형 Normal Distribution을 이룰 때는 가장 훌륭한 대표값이 되지만, 극단적인 Outlier에 대단히 취약 합니다.
만약 9명의 Junior Developer가 연봉 5,000만 원을 받고, 1명의 임원이 50억 원을 받는 조직이 있다면, 이 조직의 평균 연봉은 5억 4,500만 원으로 치솟습니다. 평균값은 집단 구성원 그 누구의 현실도 대변하지 못하는 허상이 됩니다.
2. 중앙값(Median)의 Robustness
Median은 Data를 크기순으로 나열한 뒤 정중앙에 위치한 50% 지점의 값(p50)을 취합니다. 극단값의 크기가 얼마이든 순위 자체는 밀리지 않으므로, Outlier에 대해 탁월한 Robustness(강건성) 를 발휘합니다.
바로 이 특성 때문에, 분산 System의 SLI/SLO에서는 평균 대신 Percentile 중앙값(p50)을 System의 정상 상태 기준으로 채택합니다.
3. 최빈값(Mode)이 말해주는 실무적 상태
Mode는 빈도수가 가장 높은 구간을 나타냅니다. 연속형 수치에서는 일정한 Bucket으로 이산화하여 산출합니다.
특히 Cache System처럼 "정상 경로(Cache Hit, 20ms)" 와 "지연 경로(Cache Miss 및 DB Full Scan, 80ms)" 가 공존하는 Bimodal 분포에서는 평균(50ms) 위치에 정작 요청이 단 한 건도 존재하지 않을 수 있습니다. 이때 Mode는 System이 가장 자주 머무는 실제 작동 지점을 식별해 줍니다.
두 번째 축: 불확실성의 폭을 측정하는 '퍼짐(Dispersion)'
중심 위치를 알았다고 해서 Data의 전체 그림을 파악한 것은 아닙니다. 평균 25도의 기후를 가진 도시라도, 연중 기온이 24~26도를 유지하는 하와이와 영하 15도에서 영상 40도를 오가는 대륙성 기후의 도시는 완전히 다른 생활 환경을 만듭니다.
Data가 중심으로부터 얼마나 흩어져 있는가를 측정하는 것이 바로 Dispersion(산포) 의 영역입니다.
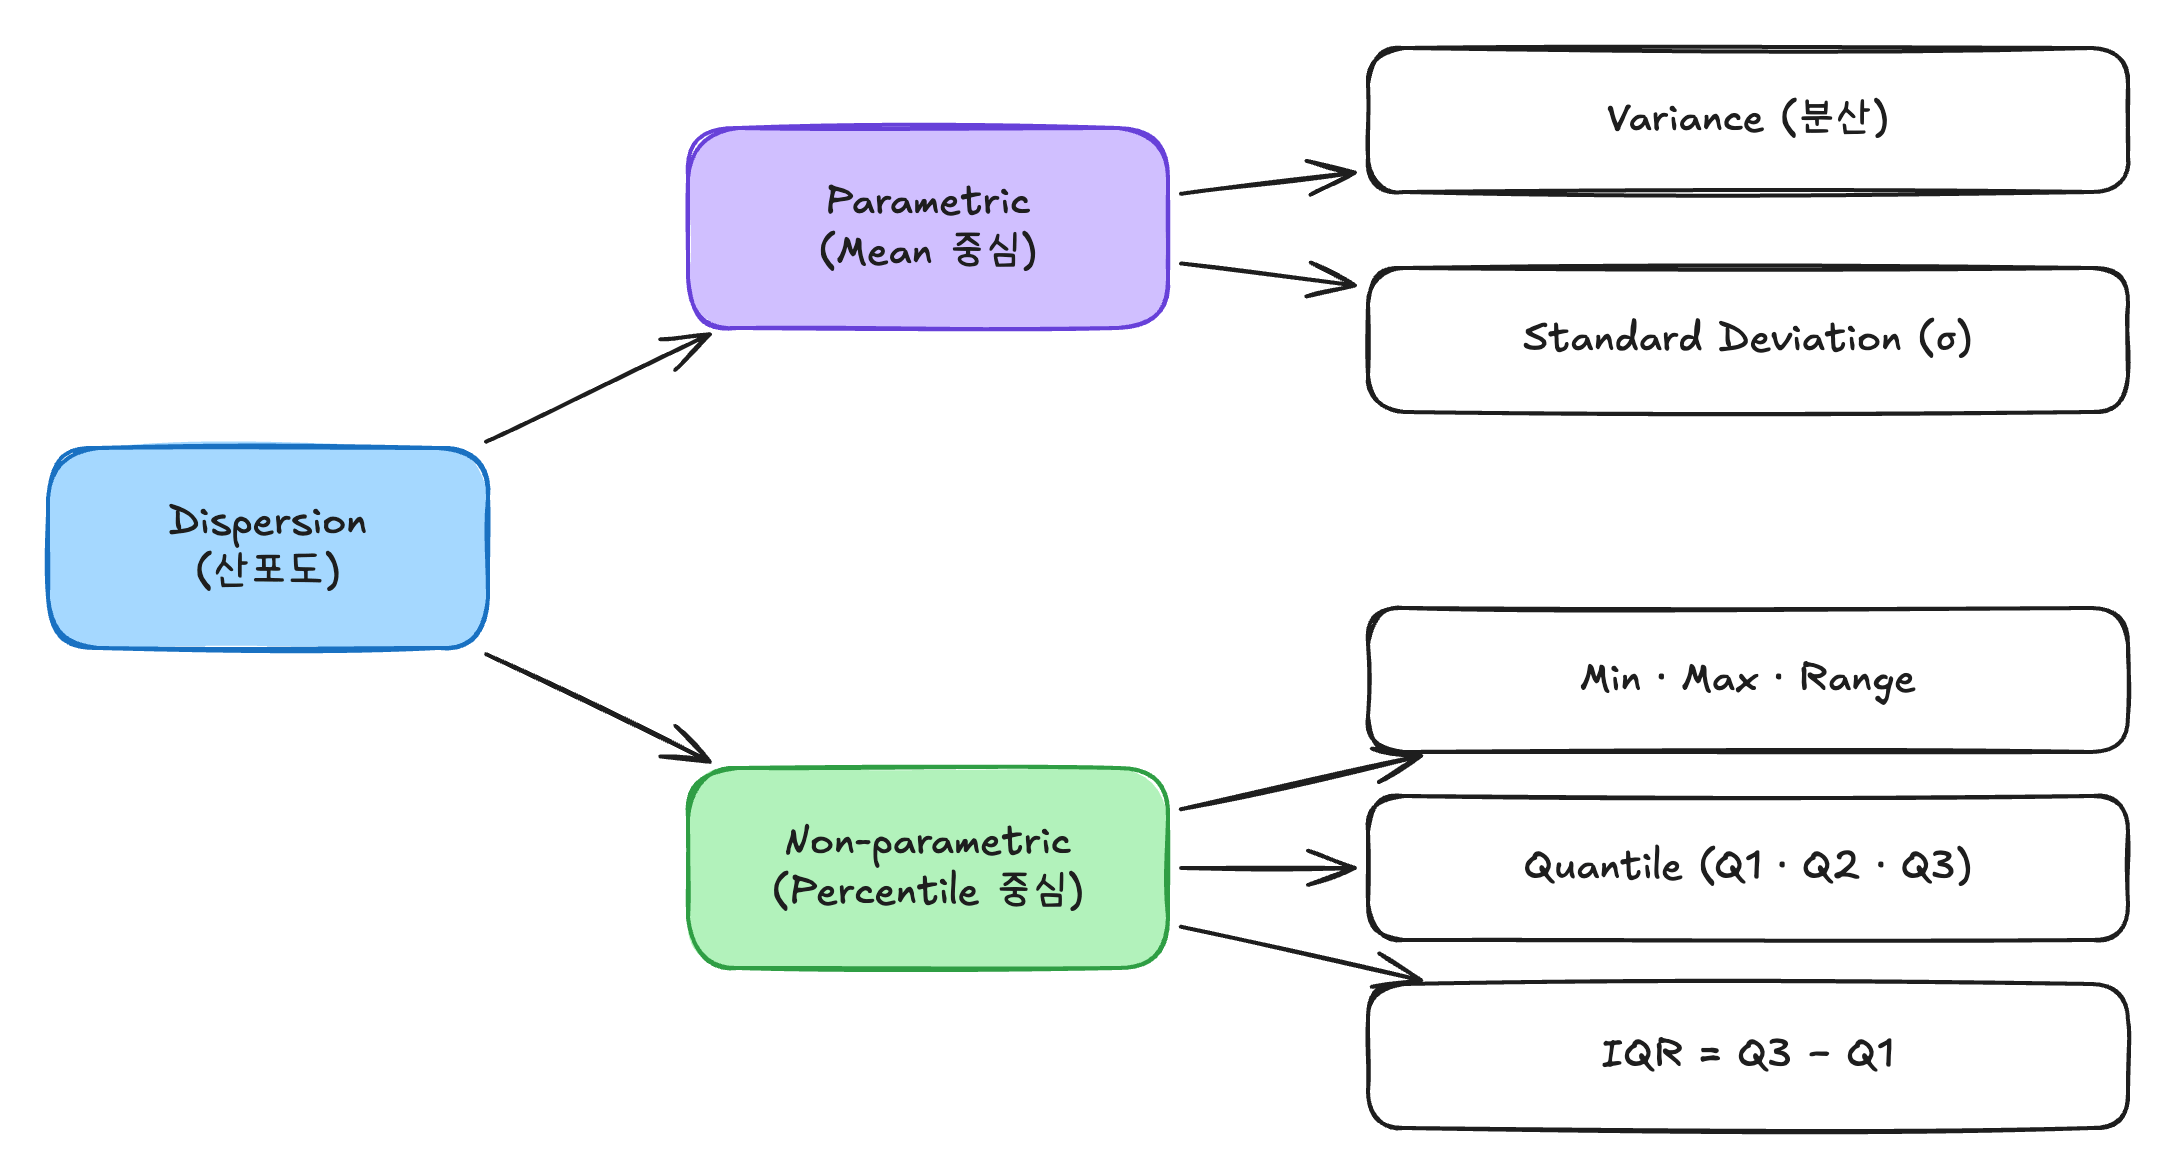
1. 표준편차(Standard Deviation: )와 분산(Variance): 평균 기준의 변동성
Standard Deviation은 각 관측치가 평균으로부터 떨어진 거리의 제곱 평균에 제곱근을 씌운 값입니다. 단위가 원래 Data와 일치하므로 직관적인 해석이 가능합니다.
그러나 Standard Deviation 역시 계산식 내부에 Mean을 포함하므로, Outlier가 유입되면 Variance와 Standard Deviation이 과도하게 부풀려지는 한계를 지닙니다.
2. Quantile과 Box Plot의 Five-Number Summary
비대칭 분포와 Outlier가 혼재된 현실 Data에서는 John Tukey가 제안한 Five-Number Summary 와 Box Plot 이 훨씬 강력한 분석 도구가 됩니다.
- 최소값(Min): Outlier를 제외한 유효 Data의 하한선
- 제1사분위수(): 하위 25% 지점의 경계
- 제2사분위수( / Median): 정중앙 50% 지점
- 제3사분위수(): 상위 25%(누적 75%) 지점의 경계
- 최대값(Max): Outlier를 제외한 유효 Data의 상한선
Box의 가로 폭인 Interquartile Range() 는 전체 Data 중 정중앙에 위치한 핵심 50% Data가 차지하는 순수한 변동 폭을 나타냅니다. 극단값들이 양끝에서 요동치더라도 IQR은 거의 영향을 받지 않습니다.
3. Outlier 탐지의 황금률: Tukey's Fences
Data Engineering Pipeline에서 Outlier를 수학적으로 판정할 때 가장 널리 쓰이는 표준 공식이 바로 규칙입니다.
이 Fence를 벗어나는 Data Point는 일반적인 표본 변동으로 보기 어려운 'Outlier'로 분류되며, Box Plot의 Whisker 바깥에 붉은 점으로 고립되어 표기됩니다.
세 번째 축: 대칭성의 붕괴와 극단값의 무게, 'Shape(분포 형태)'
동일한 Mean 50과 동일한 Standard Deviation 15를 가진 두 System이 존재한다고 가정해 보겠습니다. 두 System은 사용자에게 동일한 만족도를 제공할까요?
답은 "전혀 그렇지 않다"입니다. Data의 좌우 대칭성과 Tail의 두께를 규명하는 Shape 를 보지 않는다면 결정적인 위험을 놓치게 됩니다.
| 지표 | 수학적 정의 | System 관측 관점의 물리적 해석 |
|---|---|---|
| Skewness (왜도) | 3차 표준화 적률 () | 좌우 비대칭도. 양수(+)이면 우측으로 긴 Tail(p99 Latency 발생) |
| Kurtosis (초과 첨도) | 4차 표준화 적률 () | Tail의 두터움(Fat Tail). 양수(+)이면 극단적 Black Swan 위험 증가 |
1. Skewness: 우측 Tail과 p99 Latency의 본질
Normal Distribution처럼 완벽하게 대칭인 분포는 Skewness가 0입니다. 반면 실무에서 마주치는 대부분의 Server 응답 시간, 결제 처리 속도, Network 지연은 Positive Skewness(우측 꼬리 분포) 를 띱니다.
아래 Lab에서 [보통 Long Tail] 또는 [극단 Long Tail] 버튼을 선택해 보시기 바랍니다.
- 대다수의 평온한 요청들은 20~30ms 구간에 밀집되어 있습니다.
- 그러나 GC(Garbage Collection) Stop이나 DB Lock 경합으로 인해 발생하는 극소수의 100ms 지연 요청들이 오른쪽으로 긴 Tail을 형성합니다.
- 이 Tail은 Mean을 오른쪽으로 끌고 가며, 그 결과 Mode < Median < Mean 의 전형적인 순서가 형성됩니다.
"Mean만 바라보는 Engineer는 Tail에 갇힌 1%의 고객이 겪는 서비스 이탈을 영원히 감지하지 못합니다."
2. Kurtosis: Fat Tail과 Nassim Taleb의 Black Swan
많은 통계 입문서가 Kurtosis를 단순히 "분포의 중심 정점이 얼마나 뾰족한가"로 설명하지만, 공학적으로 Kurtosis의 본질은 "분포의 꼬리가 얼마나 무겁고 두터운가(Tail Fatness)" 에 있습니다.
초과 Kurtosis가 양수()인 분포는 Normal Distribution보다 중심도 뾰족하지만, 양쪽 Tail 끝에 극단적인 Outlier가 존재할 확률이 비약적으로 높습니다.
System Engineering 관점에서 높은 Kurtosis는 평소에는 매우 좁은 대역폭 내에서 안정적으로 동작하다가, 예기치 못한 순간에 System 한계치를 넘어서는 폭발적인 부하나 Memory Leak이 발생할 수 있는 "Black Swan 취약성"을 경고합니다.
실무 Data 관측을 위한 Engineer의 분석 Pipeline
단일 지표의 맹점에서 벗어나기 위해, 새로운 Dataset을 다루거나 Monitoring System을 설계할 때 거쳐야 하는 4단계 진단 Pipeline을 제안합니다.
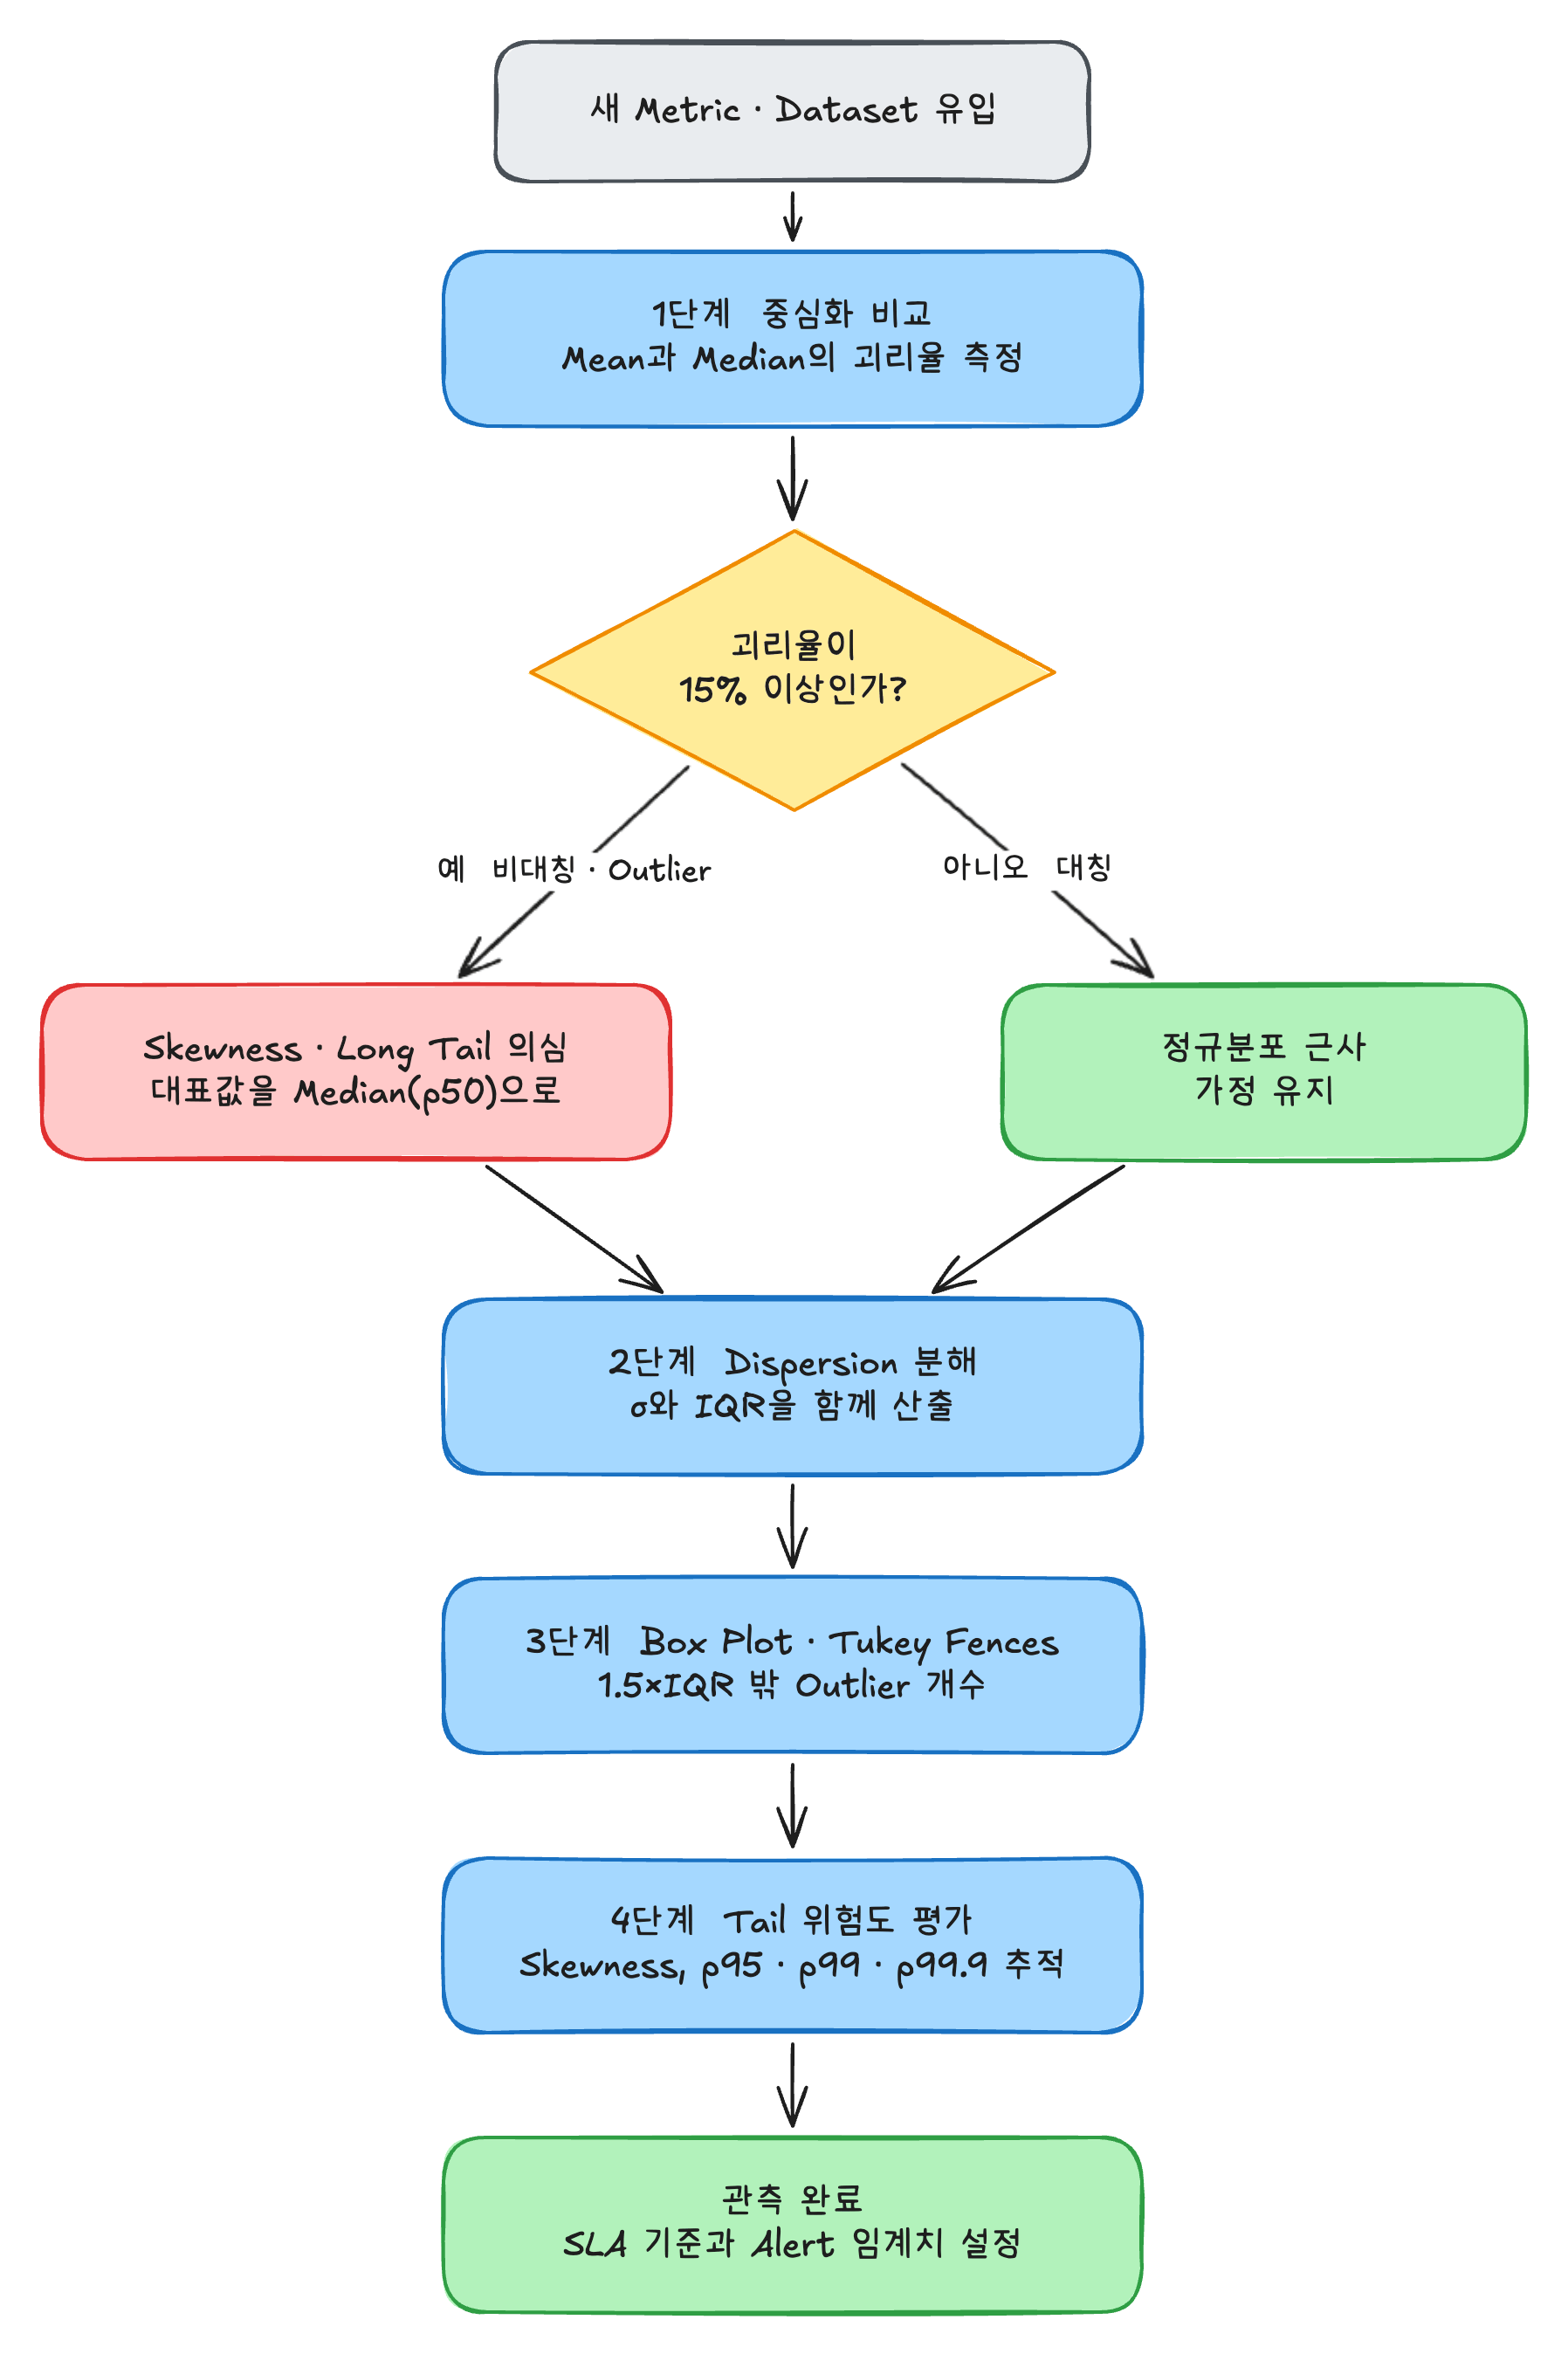
엔지니어링 체크리스트
- Dashboard의 Mean 값을 즉시 의심하십시오: Mean과 Median의 차이가 벌어져 있다면, 그 즉시 Data에 심각한 Skewness나 Outlier가 끼어있다는 신호입니다.
- Standard Deviation 단독 표기를 지양하십시오: 왜곡된 분포에서는 Standard Deviation보다
Q1,Q3,IQR이 System의 실제 가동 범위를 훨씬 더 정직하게 대변합니다. - p99와 Tail의 형상에 주목하십시오: Tail이 길고 두터울수록 Mean 중심의 System Tuning은 무력화됩니다. Tail 끝에 위치한 Process의 Bottleneck을 분리하는 Architecture적 격리(Bulkhead, Circuit Breaker)가 요구됩니다.
맺음말: 숫자가 아닌 형태를 바라보는 힘
Data는 평면적인 Scalar 값이 아닙니다. Data는 위치를 점유하고, 특정 폭으로 숨을 쉬며, 비대칭적인 Tail을 뻗어 나가는 살아있는 입체적 지형도 입니다.
기술 통계량이 제공하는 3대 축—중심화(Central Tendency), 퍼짐(Dispersion), 분포 형태(Shape)—을 유기적으로 엮어 이해할 때, Engineer는 비로소 요약 지표의 안락한 착시에서 벗어나 System이 보내오는 실제 신호와 위험을 온전히 마주할 수 있습니다.